CRUD: As 4 operações no Modelo de Dados
Operações CRUD: Create, Read, Update e Delete no Modelo de Dados
1. Introdução
Toda instância armazenada em um esquema de banco de dados relacional passa, ao longo de seu ciclo de vida, por um conjunto finito de operações possíveis sobre os dados que a compõem. Esse conjunto recebe, na literatura de engenharia de software e de administração de dados, a designação de CRUD: um acrônimo formado pelas iniciais de quatro verbos em inglês: create [criar], read [ler], update [atualizar] e delete [excluir]. A relevância do acrônimo está na completude do que ele descreve: qualquer manipulação de persistência de dados, independentemente da linguagem, do sistema de gerenciamento de banco de dados ou da camada de aplicação envolvida, reduz-se a uma combinação dessas quatro operações elementares.
O presente texto trata exclusivamente das operações CRUD, consideradas um conceito autônomo de manipulação de instâncias em um esquema já definido. A definição do próprio esquema [entidade, atributo, chave primária, chave estrangeira, cardinalidade] constitui objeto de outro material, dedicado à modelagem entidade-relacionamento, ao qual este texto remete o leitor interessado na etapa anterior de projeto do banco de dados. Aqui, o esquema é pressuposto: o foco recai sobre o que se pode fazer com as instâncias de um esquema já estabelecido, sob qual verbo de linguagem de consulta estruturada [SQL] cada operação se expressa, sob qual verbo do protocolo HTTP cada operação encontra correspondência quando exposta por uma interface de programação de aplicações [API] do tipo REST, e sob quais condições cada operação preserva ou compromete a integridade referencial do esquema.
2. Origem do termo e consolidação do acrônimo
A atribuição mais citada na literatura de administração de dados para a consolidação do acrônimo CRUD aponta para a obra de James Martin, Managing the Data-base Environment [MARTIN, 1983], na qual o autor sistematiza as quatro operações fundamentais de manipulação de dados como categoria analítica para o desenho de sistemas de informação. A pesquisa disponível para a elaboração deste texto sustenta apenas a atribuição corrente e mais estável encontrada na literatura secundária sobre o tema, sem sustentar certeza documental completa quanto à prioridade absoluta de cunhagem do termo por Martin em relação a outros autores da mesma época que trabalhavam com taxonomias equivalentes de operações de dados; é nesses termos, com a ressalva expressa de incerteza quanto à prioridade exata, que este texto apresenta a referência de 1983.
A independência do conceito CRUD em relação a qualquer linguagem ou tecnologia específica explica a durabilidade do acrônimo. As quatro operações antecedem historicamente tanto a linguagem SQL, formalizada ao final da década de 1980 pela normatização técnica [Seção 4], quanto a arquitetura REST, descrita apenas em 2000. O acrônimo funciona como uma camada de descrição conceitual, estável ao longo de décadas de mudanças tecnológicas na camada de implementação.
3. As quatro operações fundamentais
A exposição de cada operação precede a tabela comparativa da Seção 3.5, na ordem canônica do próprio acrônimo. Cada operação corresponde a um efeito distinto e mutuamente exclusivo sobre o estado de uma instância em uma tabela do esquema relacional.
3.1 Create [criação]
A operação de criação insere uma nova instância em uma tabela do esquema, atribuindo valores aos campos definidos pela estrutura da entidade e gerando, quando aplicável, um novo valor de chave primária para identificar essa instância de modo único. A criação é a única das quatro operações que faz com que uma instância passe a existir a partir de um estado anterior de ausência: o estado anterior à operação é a ausência da linha correspondente na tabela, e o estado posterior é a presença dessa linha com os valores fornecidos. Toda criação bem-sucedida pressupõe a satisfação de eventuais restrições de integridade do esquema, como a unicidade da chave primária, a obrigatoriedade de campos não nulos e a validade das referências a chaves estrangeiras que apontam para tabelas relacionadas.
3.2 Read [leitura]
A operação de leitura recupera uma ou mais instâncias já existentes em uma ou mais tabelas do esquema, segundo critérios de filtragem, ordenação, agrupamento ou junção entre tabelas relacionadas, sem alterar o estado armazenado dos dados consultados. A leitura distingue-se estruturalmente das demais três operações por preservar o conteúdo do banco de dados: pode ser executada repetidamente, em qualquer ordem e em qualquer volume, sem produzir efeitos colaterais nas instâncias consultadas. Essa característica, tratada com precisão técnica na Seção 5.1, qualifica a leitura como uma operação segura e idempotente.
3.3 Update [atualização]
A operação de atualização modifica um ou mais valores de campo de uma instância já existente, preservando a identidade dessa instância [a chave primária permanece inalterada] e a própria existência da linha na tabela. A atualização redefine o estado atual de uma instância sem afetar seu histórico anterior, salvo quando o esquema prevê um mecanismo explícito de versionamento ou de auditoria temporal, hipótese em que o estado anterior é preservado em uma estrutura complementar, distinta da tabela principal. Toda atualização está sujeita às mesmas restrições de integridade aplicáveis à criação, com a diferença de que a validação recai apenas sobre o novo valor proposto para cada campo alterado, em vez da totalidade da linha.
3.4 Delete [remoção]
A operação de remoção extingue a existência de uma instância em uma tabela de um esquema, removendo a linha correspondente do conjunto de dados ativos. A remoção admite duas modalidades distintas na prática de administração de dados: a remoção física, que apaga definitivamente a linha da estrutura de armazenamento, e a remoção lógica [também chamada de soft delete], que preserva a linha fisicamente, sinalizando-a como inativa por meio de um campo de controle [por exemplo, um carimbo de data de exclusão ou um indicador booleano], sem que a linha deixe de existir na tabela. A escolha entre as duas modalidades decorre de um requisito de auditoria, de conformidade regulatória ou da necessidade de recuperar dados excluídos por engano. A definição conceitual da própria operação CRUD, por sua vez, corresponde apenas à eliminação lógica da instância enquanto elemento ativo do domínio representado, independentemente de qualquer uma das duas implementações físicas escolhidas.
3.5 Quadro comparativo das quatro operações
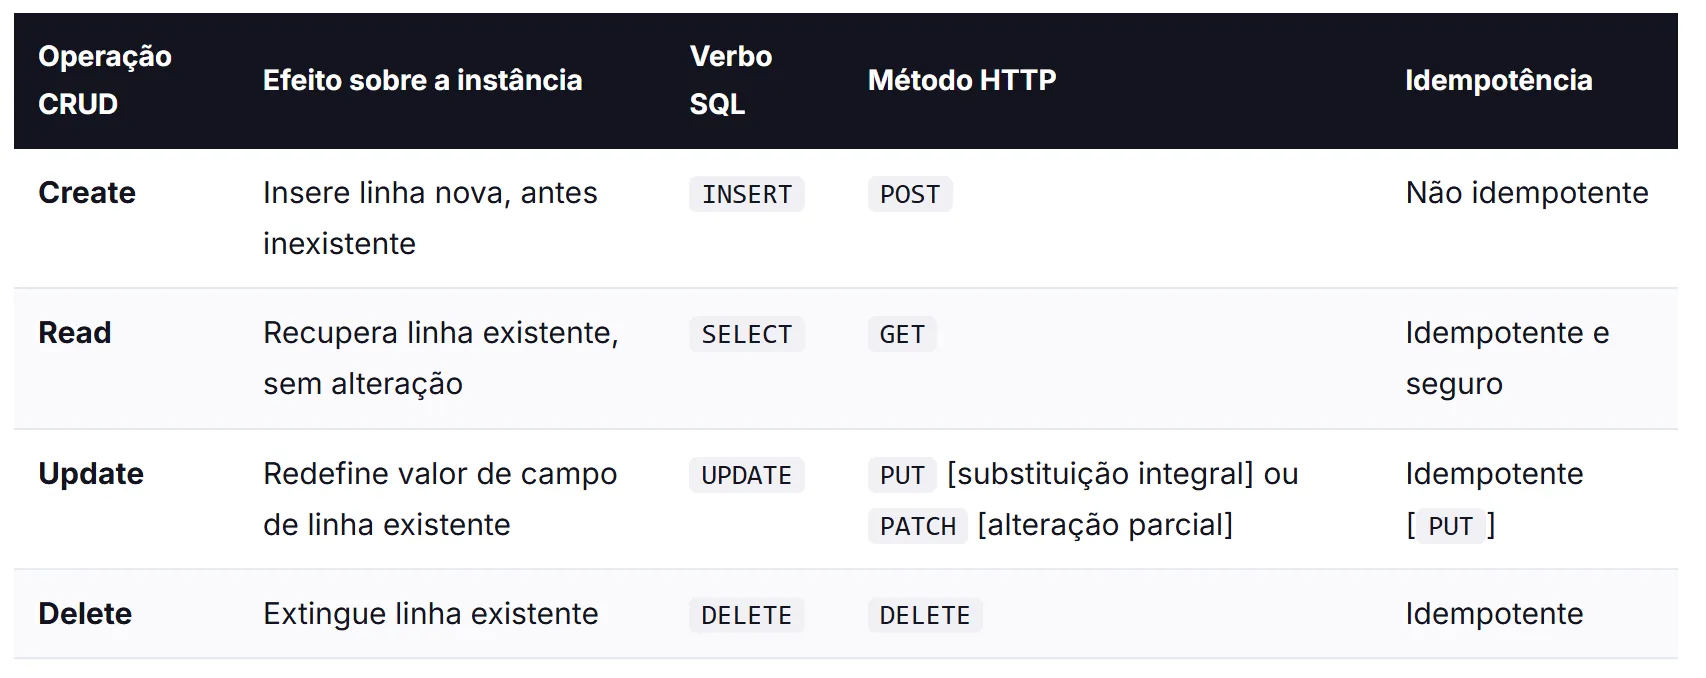
Tabela 1. Correspondência entre as operações CRUD, os verbos de manipulação de dados em SQL, os métodos HTTP equivalentes em uma API REST e a propriedade de idempotência de cada operação.
4. Correspondência com a linguagem de manipulação de dados SQL
A linguagem SQL [Structured Query Language, linguagem de consulta estruturada] normatiza, dentro do seu subconjunto denominado DML [Data Manipulation Language, linguagem de manipulação de dados], quatro comandos que correspondem, um a um, às quatro operações CRUD: INSERT para criação, SELECT para leitura, UPDATE para atualização e DELETE para remoção. A primeira normatização internacional da linguagem SQL foi publicada pela International Organization for Standardization sob a designação ISO 9075:1987, intitulada Information processing systems — Database language — SQL [INTERNATIONAL ORGANIZATION FOR STANDARDIZATION, 1987], correspondente à normatização homóloga do American National Standards Institute sob a designação ANSI X3.135. A norma evoluiu por sucessivas revisões ao longo das décadas seguintes, e o núcleo dos quatro comandos de manipulação de dados manteve-se estável desde a primeira edição.
A convergência entre as operações CRUD e os quatro comandos DML do SQL decorre de uma identidade estrutural entre as duas taxonomias: a própria taxonomia CRUD descreve, em um nível de abstração independente da linguagem, o mesmo conjunto de operações que a linguagem SQL formaliza em nível sintático. Um comando UPDATE em SQL sempre exige uma cláusula de condição [WHERE] para delimitar quais linhas recebem a alteração, e a ausência dessa cláusula resulta na atualização de toda a tabela, comportamento que ilustra por que a operação de atualização, embora idempotente quando aplicada com o mesmo critério de seleção e o mesmo valor de destino, exige rigor na especificação para preservar a integridade do conjunto de dados alheio à alteração pretendida.
5. Correspondência com os métodos HTTP e a arquitetura REST
Quando uma aplicação expõe operações sobre um banco de dados por meio de uma interface de programação de aplicações [API], segundo o estilo arquitetural REST [Representational State Transfer], cada operação CRUD corresponde a um método do protocolo HTTP. A semântica desses métodos está normatizada pela Request for Comments RFC 7231, Hypertext Transfer Protocol [HTTP/1.1]: Semantics and Content, publicada pela Internet Engineering Task Force em junho de 2014, de autoria de Roy Fielding e Julian Reschke [FIELDING; RESCHKE, 2014]. O método POST corresponde à criação, o método GET corresponde à leitura, os métodos PUT e PATCH correspondem à atualização, e o método DELETE corresponde à remoção, na mesma correspondência já sistematizada na Tabela 1.
5.1 Idempotência e segurança dos métodos: definição e aplicação às operações CRUD
A RFC 7231 define método idempotente como aquele cuja execução repetida, com os mesmos parâmetros, produz sobre o servidor o mesmo efeito de uma única execução, ainda que a resposta individual de cada chamada possa variar [FIELDING; RESCHKE, 2014]. Define-se, ainda, método seguro como aquele que preserva o estado armazenado no servidor, sem produzir efeito de alteração, sendo destinado apenas à recuperação de informação. Segundo essa dupla classificação, o método GET é simultaneamente seguro e idempotente, os métodos PUT e DELETE são idempotentes sem serem seguros, e o método POST carece das duas propriedades, seguro e idempotente.
A aplicação dessa classificação às operações CRUD explica a ausência de idempotência na criação de uma instância [POST/INSERT]: repetir a mesma chamada de criação duas vezes produz, em regra, duas instâncias distintas, cada uma com sua própria chave primária gerada pelo sistema. Já a atualização por substituição integral [PUT/UPDATE com o mesmo valor de destino] e a remoção [DELETE] são idempotentes: repetir a mesma chamada de atualização produz, na segunda e nas execuções subsequentes, o mesmo estado final já alcançado pela primeira execução, e repetir a mesma chamada de remoção sobre uma instância já removida mantém o mesmo estado extinto alcançado pela primeira execução bem-sucedida, sem efeito adicional. A leitura, por sua vez, une as duas propriedades: é segura, pois preserva o estado armazenado, e é idempotente, pois qualquer número de execuções sucessivas com o mesmo critério de consulta produz o mesmo resultado, na ausência de alteração concorrente dos dados subjacentes por outra operação.
6. Integridade referencial nas operações de atualização e remoção
O modelo relacional de dados, formalizado por Edgar F. Codd em 1970 [CODD, 1970], estabelece a chave estrangeira como o mecanismo estrutural que garante a integridade referencial entre tabelas relacionadas: uma instância de uma tabela subordinada só pode referenciar uma instância existente da tabela referenciada, e essa restrição impõe consequências específicas quando a instância referenciada é atualizada ou removida. Elmasri e Navathe sistematizam as três estratégias que um sistema gerenciador de banco de dados relacional pode adotar diante da tentativa de remover ou de alterar a chave primária de uma instância referenciada por chave estrangeira em outra tabela [ELMASRI; NAVATHE, 2015]: a estratégia de restrição [ON DELETE RESTRICT], que impede a remoção ou a alteração enquanto existir referência ativa; a estratégia de propagação em cascata [ON DELETE CASCADE], que remove ou atualiza automaticamente todas as instâncias subordinadas que referenciam a instância afetada; e a estratégia de anulação [ON DELETE SET NULL], que preserva a instância subordinada, atribuindo valor nulo ao campo de chave estrangeira que apontava para a instância removida.
A escolha entre as três estratégias constitui uma decisão de projeto do esquema, tomada em função do significado de negócio da relação entre as tabelas envolvidas, distinta da imposição técnica única do sistema de gerenciamento de banco de dados. Uma relação entre pedido e item de pedido tende a adotar propagação em cascata, porque um item de pedido carece de sentido autônomo na ausência do pedido a que pertence; uma relação entre funcionário e departamento tende a adotar restrição ou anulação, porque a remoção de um departamento deveria preservar o registro dos funcionários vinculados a esse departamento, em vez de apagá-lo silenciosamente.
7. Ciclo de vida da instância: exemplo aplicado
A Figura 1 representa o ciclo de vida típico de uma instância ao longo das quatro operações CRUD, evidenciando três características estruturais discutidas nas seções anteriores. Em primeiro lugar, o fluxo principal segue a sequência canônica de criação, leitura, atualização e eliminação [remoção; extinção], em que cada seta representa a transição de estado correspondente. Em segundo lugar, a operação de leitura ocupa posição estrutural distinta das demais três: o laço superior, em traço tracejado dourado, indica que a leitura pode ser acionada de modo repetível e independente, sem relação de precedência obrigatória com as demais operações, ao contrário do que a posição da leitura na sequência principal poderia sugerir isoladamente. Em terceiro lugar, o arco inferior conecta a remoção à criação, indicando que a extinção de uma instância mantém o esquema ativo como um todo: um novo registro, com nova chave primária, inicia um novo ciclo, estruturalmente idêntico e funcionalmente independente do ciclo anterior.
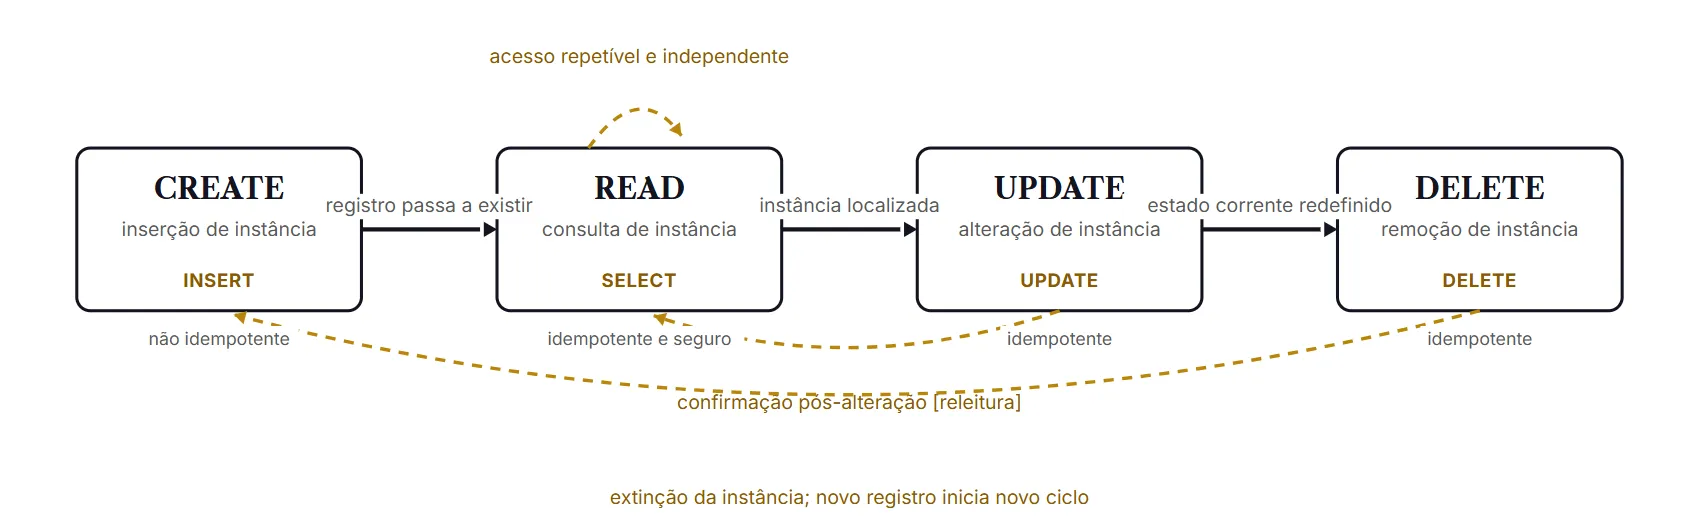
Figura 1. Ciclo de vida de uma instância nas quatro operações CRUD. Fluxo principal em traço contínuo na cor navy; relações de independência, confirmação e reinício de ciclo em traço tracejado dourado. Elaboração própria, com base na correspondência sistematizada nas Seções 3 a 5 [MARTIN, 1983; FIELDING; RESCHKE, 2014].
Em Linguagem Simples
CRUD é a lista das quatro coisas que qualquer sistema faz com um dado guardado em um banco de dados: criar um registro novo, ler um registro que já existe, mudar um valor de um registro que já existe, ou apagar um registro que já existe. Toda tela de cadastro, toda busca, toda edição de perfil e todo botão de exclusão de um aplicativo, por trás da interface visível, acionam uma dessas quatro operações em uma tabela de banco de dados.
Ler um registro várias vezes mantém tudo exatamente igual, e por isso a leitura é chamada de operação segura. Apagar o mesmo registro duas vezes produz efeito apenas na primeira tentativa, porque na segunda tentativa o registro já se encontra apagado, e por isso a exclusão é chamada de operação idempotente. Criar é a única das quatro operações que muda de resultado a cada repetição: pedir para criar o mesmo cadastro duas vezes tende a gerar dois cadastros diferentes, cada um com seu próprio número de identificação.
FAQ
O acrônimo CRUD corresponde a uma tecnologia específica ou a um conceito de arquitetura?
CRUD é um conceito, independentemente da tecnologia. Descreve quatro categorias de operação sobre dados persistidos, aplicáveis a qualquer sistema gerenciador de banco de dados relacional ou não relacional, e a qualquer linguagem de programação usada na camada de aplicação.
Toda operação executada em um banco de dados se enquadra em uma das quatro categorias CRUD?
A afirmação aplica-se a operações de manipulação de instâncias individuais. Operações de definição de esquema [criação e alteração de tabelas, índices ou restrições, pertencentes ao subconjunto DDL da linguagem SQL] atuam sobre a estrutura do banco de dados, distintas das instâncias armazenadas nessa estrutura, razão pela qual permanecem fora do escopo conceitual do acrônimo CRUD.
Qual a diferença entre PUT e PATCH na correspondência com a operação de atualização?
PUT substitui integralmente a representação de um recurso, exigindo o envio de todos os campos da instância, ainda que apenas um deles seja efetivamente alterado, e, por isso, é idempotente por definição na RFC 7231. PATCH aplica uma alteração parcial, enviando somente os campos modificados; a RFC 7231 deixa a idempotência de PATCH em aberto, sem classificação automática, de modo que a idempotência da operação de atualização parcial depende da natureza específica de cada alteração aplicada [uma alteração que redefine um campo para um valor fixo é idempotente; uma alteração que incrementa um contador carece dessa propriedade].
A remoção lógica [soft delete] ainda é considerada a operação de remoção do CRUD?
Sim. A operação CRUD de remoção define-se pelo efeito lógico de extinguir uma instância enquanto elemento ativo do domínio representado, efeito produzido tanto pela remoção física quanto pela remoção lógica. A escolha da implementação é uma decisão de projeto de esquema, tratada na Seção 3.4, e mantém inalterada a classificação conceitual da operação.
Por que a ausência de idempotência caracteriza a operação de criação, se a leitura subsequente do registro criado sempre retorna o mesmo resultado?
A idempotência refere-se ao efeito da própria operação executada repetidamente, distinto do efeito de uma operação subsequente [a leitura] executada depois dela. Repetir a chamada de criação duas vezes tende a produzir duas instâncias com chaves primárias distintas, ainda que os demais campos recebam valores idênticos, e esse resultado, uma segunda instância onde antes só existia a primeira, é precisamente o efeito que caracteriza a ausência de idempotência.
A leitura é sempre uma operação segura, mesmo quando envolve funções de agregação ou de ordenação complexa?
Sim. A segurança do método, na definição da RFC 7231, refere-se à ausência de alteração do estado armazenado, independentemente da complexidade computacional da consulta. Uma consulta com agregação, junção entre várias tabelas ou ordenação elaborada permanece segura, porque nenhuma dessas operações modifica o conteúdo das tabelas consultadas, apenas processa e apresenta os dados já existentes.
As quatro operações CRUD constituem a camada conceitual mais estável da manipulação de dados, anterior e independente das tecnologias específicas de linguagem de consulta ou de arquitetura de interface que a implementam em cada época. A correspondência sistematizada neste texto entre CRUD, os comandos DML do SQL e os métodos do protocolo HTTP evidencia essa estabilidade: mudam as tecnologias de superfície, permanece o conjunto fechado de quatro operações elementares sobre o estado de uma instância em um esquema de dados.
Glossário
API [Application Programming Interface]
Interface de programação de aplicações; conjunto de rotinas e protocolos que permite a comunicação entre sistemas de software distintos.
CRUD
Acrônimo de create, read, update e delete; conjunto das quatro operações fundamentais de manipulação de instâncias em um esquema de dados.
DML [Data Manipulation Language]
Subconjunto da linguagem SQL dedicado à manipulação de instâncias já existentes em um esquema, composto pelos comandos INSERT, SELECT, UPDATE e DELETE.
Idempotência
Propriedade de uma operação cuja execução repetida, com os mesmos parâmetros, produz sobre o estado armazenado o mesmo efeito que uma única execução.
Instância
Ocorrência individual de uma entidade no esquema, correspondente a uma linha de uma tabela, com valores próprios para cada atributo definido pela estrutura da entidade.
Integridade referencial
Propriedade do esquema relacional que garante que toda referência de chave estrangeira aponte para uma instância existente na tabela referenciada.
Método seguro [HTTP]
Método do protocolo HTTP que preserva o estado armazenado no servidor, destinado apenas à recuperação de informação.
REST [Representational State Transfer]
Estilo arquitetural para sistemas distribuídos baseado no protocolo HTTP, no qual os recursos são manipulados por meio de métodos padronizados correspondentes às operações CRUD.
Soft delete [remoção lógica]
Modalidade de remoção que preserva fisicamente a linha na tabela, marcando-a como inativa por meio de um campo de controle, em vez de apagá-la definitivamente da estrutura de armazenamento.
SQL [Structured Query Language]
Linguagem de consulta estruturada, normatizada internacionalmente, para a definição e a manipulação de dados em sistemas gerenciadores de bancos de dados relacionais.
Referências Bibliográficas
CODD, E. F. A relational model of data for large shared data banks. Communications of the ACM, v. 13, n. 6, p. 377-387, jun. 1970.
ELMASRI, Ramez; NAVATHE, Shamkant B. Fundamentals of Database Systems. 7. ed. Boston: Pearson, 2015.
FIELDING, Roy; RESCHKE, Julian. Hypertext Transfer Protocol [HTTP/1.1]: Semantics and Content. RFC 7231. Internet Engineering Task Force, jun. 2014.
INTERNATIONAL ORGANIZATION FOR STANDARDIZATION. ISO 9075:1987. Information processing systems — Database language — SQL. Geneva: ISO, 1987.
MARTIN, James. Managing the Data-base Environment. Englewood Cliffs: Prentice-Hall, 1983.